آیا STM32 میتواند خرابی موتور را پیش از وقوع تشخیص دهد؟
TinyML، تحلیل ارتعاش و نگهداری پیشگویانه؛ از سنسور تا تصمیم روی میکروکنترلر
چرا دقت بالا بهتنهایی کافی نیست ؟
نشت داده چگونه نتایج را فریب میدهد ؟
یک سامانه صنعتی واقعاً چه چیزی باید روی MCU اجرا کند ؟
نویسنده: مینا حسنزاده | مهندس برق و الکترونیک | سیستمهای نهفته و هوش مصنوعی لبه
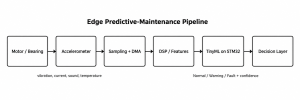 شکل 1 ـ معماری کلی پایش وضعیت موتور با TinyML
کلیدواژهها:
STM32، TinyML، هوش مصنوعی لبه، نگهداری پیشگویانه، پایش وضعیت، تشخیص خرابی بیرینگ، تحلیل ارتعاش، FFT، تشخیص ناهنجاری، نشت داده و CMSIS-NN
خلاصه مقاله
اجرای مدل یادگیری ماشین روی STM32 شدنی است؛ اما «تشخیص خرابی» با «پیشبینی خرابی» یکی نیست. اگر داده، روش اعتبارسنجی و معماری تصمیمگیری درست نباشد، حتی مدلی با دقت ظاهری بسیار بالا هم ممکن است در کارخانه عملکرد قابل اتکایی نداشته باشد.
مقدمه: موتور هنوز کار میکند، اما دادهها چیز دیگری میگویند
موتور هنوز میچرخد. صدای غیرعادی واضحی شنیده نمیشود و اپراتور هم میگوید همهچیز عادی است. با این حال، در سیگنال ارتعاش ممکن است تغییر کوچکی شکل گرفته باشد؛ تغییری که روزها یا حتی هفتهها پیش از خرابی جدی آغاز میشود. سؤال اصلی من این است: آیا میتوان همین تغییر را در کنار موتور و با یک میکروکنترلر STM32 تشخیص داد؟
جواب کوتاه من «بله، در بسیاری از سناریوها» است؛
اما پاسخ مهندسی به یک بله ساده ختم نمیشود. باید دقیق بدانیم چه خرابیای را دنبال میکنیم، چه سیگنالی در اختیار داریم، داده چگونه جمعآوری شده، مدل چه وظیفهای دارد، با چه روشی اعتبارسنجی شده و در نهایت با چه محدودیتهایی از نظر حافظه، زمان اجرا و انرژی روی میکروکنترلر قرار میگیرد. مرور جامع TinyML برای نگهداری پیشگویانه نیز بر همین نگاه سرتاسری تأکید دارد؛ داده، مدل، سختافزار، ابزار و کاربرد باید همزمان دیده شوند [1].
در این مقاله از تعریفهای عمومی هوش مصنوعی عبور میکنم و مسیر یک پروژه واقعی را بررسی میکنم:
از دریافت سیگنال ارتعاش تا رسیدن به یک تصمیم قابل اتکا روی STM32 .در این مسیر به یکی از مهمترین تلههای پژوهشهای تشخیص خرابی هم میرسیم: نشت داده (Data Leakage). این خطا میتواند نتیجهای نزدیک به صددرصد ایجاد کند، در حالی که مدل واقعاً توان تعمیم به یک بیرینگ یا ماشین جدید را ندارد [5][6].
1.یک مرز علمی مهم: تشخیص خرابی با نگهداری پیشگویانه یکی نیست
پیش از انتخاب مدل باید سه مسئله متفاوت را از هم جدا کنیم. در بسیاری از پروژهها این مرزها با هم مخلوط میشوند و از یک طبقهبندی ساده، نتیجه «پیشبینی خرابی» گرفته میشود. برای یک مقاله علمی یا محصول حرفهای، نوع ادعا باید دقیقاً با نوع داده و خروجی مدل هماهنگ باشد.
| خروجی نمونه | داده موردنیاز | سؤال اصلی | مسئله |
|---|---|---|---|
| Normal / Anomaly یا امتیاز ناهنجاری | معمولاً داده نرمال کافی است و برچسب خرابی الزامی نیست. | آیا رفتار فعلی با حالت نرمال تفاوت دارد؟ | تشخیص ناهنجاری |
| Bearing / Misalignment / Unbalance و … | نمونههای برچسبخورده از کلاسهای مختلف خرابی | اگر سیستم خراب است، نوع خرابی چیست؟ | تشخیص نوع خرابی |
| عمر مفید باقیمانده یا افق زمانی تعمیر | داده تخریب در طول زمان و اطلاعات Time-to-Failure | چقدر تا خرابی یا آستانه تعمیر باقی مانده است؟ | پیشآگاهی و RUL |
اگر مدل فقط بین «سالم» و «خراب» طبقهبندی کند، لزوماً خرابی را پیش از وقوع پیشبینی نکرده است. برای ادعای RUL یا پیشبینی زمان خرابی، به داده تخریب زمانی و یک پروتکل پیشآگاهی واقعی نیاز داریم.
مرورهای منتشرشده بین سالهای ۲۰۲۴ تا ۲۰۲۶ درباره تشخیص خرابی بیرینگ نیز همین فاصله را نشان میدهند: نتایج آزمایشگاهی در طبقهبندی فراوان است، اما تعمیم به شرایط عملیاتی متغیر، خرابی واقعی، عدمتعادل کلاسها و انتقال دامنه همچنان چالش جدی باقی مانده است [2][3][4].
2.چرا هوش مصنوعی لبه و TinyML؟ چرا همهچیز را به فضای ابری نفرستیم؟
در معماری سنتی، سنسور داده را جمع میکند و حجم زیادی از داده خام برای تحلیل به دروازه شبکه، سرور یا فضای ابری فرستاده میشود. این روش در بسیاری از کاربردها منطقی است. اما وقتی پاسخ باید سریع باشد، اتصال شبکه همیشه قابل اتکا نیست، پهنای باند محدود است یا ارسال پیوسته داده ارتعاش هزینه بالایی دارد، پردازش نزدیک سنسور مزیت جدی پیدا میکند [1][15][16].
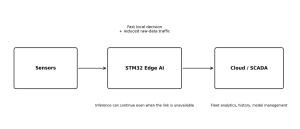 شکل 2 ـ هوش مصنوعی لبه قرار نیست فضای ابری را حذف کند؛تصمیم اولیه نزدیک سنسور گرفته میشود و فضای ابری برای تحلیل ناوگان، تاریخچه و مدیریت مدل باقی میماند.
- کاهش تأخیر: تصمیم اولیه بدون رفتوبرگشت شبکه انجام میشود.
- کاهش ترافیک: بهجای ارسال سیگنال خام میتوان ویژگیها، رخدادها یا امتیاز سلامت (Health Score) را ارسال کرد.
- استقلال نسبی از ارتباط: قطع شبکه نباید پایش محلی را متوقف کند.
- کنترل بهتر بر داده: در بعضی صنایع، خروج داده خام از سایت مطلوب یا حتی مجاز نیست.
- کاهش انرژی ارتباطی: در گرههای باتریخور، ارسال رادیویی میتواند از خود استنتاج مدل پرهزینهتر باشد [16][19].
TinyML در کنار این مزایا محدودیتهای واقعی دارد: RAM و Flash محدود، توان پردازشی محدود و بودجه انرژی مشخص. بنابراین مدلی که روی لپتاپ بیشترین دقت را دارد، الزاماً بهترین مدل برای میکروکنترلر نیست. دقت، زمان اجرا، حافظه و انرژی باید همزمان ارزیابی شوند [14][15][16][17].
3. از ارتعاش خام تا ورودی مدل؛ بخشی که زیر سایه AI گم میشود
اگر سنسور بد نصب شده باشد، نرخ نمونهبرداری اشتباه انتخاب شود یا شرطیسازی سیگنال ناقص باشد، مدل یادگیری ماشین فقط همان خطا را با ظاهر پیچیدهتری پردازش میکند. به همین دلیل من زنجیره طراحی را از سنسور شروع میکنم، نه از شبکه عصبی.
3.1 انتخاب سنسور و نرخ نمونهبرداری
شتابسنج باید از نظر باند فرکانسی، دامنه اندازهگیری، نویز و روش نصب با پدیده مکانیکی موردنظر سازگار باشد. نرخ نمونهبرداری نیز باید متناسب با بیشترین فرکانس مفید انتخاب شود و فیلتر ضدعلیاس در نظر گرفته شود. در دیتاست CWRU، دادههای سمت محرک با نرخهای ۱۲ و ۴۸ کیلوهرتز در دسترس است [7]. در مقابل، یک نمونه TinyML منتشرشده در سال ۲۰۲۵ روی یک نمونه آزمایشگاهی فن (Fan Mockup) با نرخ ۱۰۰ هرتز کار کرده است [9]. این دو عدد را بدون توجه به نوع ماشین، سرعت دوران و هدف تشخیص نمیتوان با هم مقایسه کرد.
3.2 پنجرهبندی و ویژگیهای حوزه زمان
سیگنال پیوسته معمولاً به پنجرههای کوتاه تقسیم میشود. طول پنجره و میزان همپوشانی باید طوری انتخاب شود که الگوی موردنظر در هر پنجره دیده شود، اما حافظه و زمان اجرا بیدلیل افزایش پیدا نکند. چند ویژگی کلاسیک هنوز برای MCU بسیار ارزشمند هستند:RMS = sqrt((1/N) × Σ xᵢ²)RMS دامنه مؤثر ارتعاش را در هر پنجره نشان میدهد و برای پایش شدت کلی سیگنال مفید است.
Crest Factor = max(|xᵢ|) / RMSCrest Factorنسبت قله سیگنال به RMS است و میتواند نسبت به ضربههای موضعی حساس باشد.Kurtosis = E[(x − μ)⁴] / σ⁴Kurtosis میزان ضربهایبودن و شکل توزیع سیگنال را توصیف میکند؛ با این حال، مقدار آن باید در شرایط کاری مختلف اعتبارسنجی شود.
3.3 حوزه فرکانس؛ FFT هنوز در کنار یادگیری ماشین ارزش دارد
FFT رقیب یادگیری ماشین نیست. روی MCU، تبدیل یک پنجره ارتعاش به مجموعه کوچکی از ویژگیهای طیفی گاهی منطقیتر از واردکردن کل سیگنال خام به یک شبکه بزرگ است. پژوهشهای TinyML روی موتور نیز ترکیب FFT و مدلهای سبک را گزارش کردهاند [9]. علاوه بر فرکانس غالب، میتوان انرژی باندها، آنتروپی طیفی، نسبت هارمونیکها و ویژگیهای وابسته به سرعت دوران را بررسی کرد.
| نکته مهندسی | هزینه روی MCU | نمونهها | گروه ویژگی |
|---|---|---|---|
| ساده و تفسیرپذیر؛ ممکن است به Load و Speed حساس باشد. | کم تا متوسط | RMS، Peak، Std، Crest Factor، Kurtosis | حوزه زمان |
| برای الگوهای تناوبی و امضاهای بیرینگ مفید است. | متوسط | FFT bins، Band Energy، Dominant Frequency | حوزه فرکانس |
| برای رفتارهای غیرایستا قویتر است، اما RAM و محاسبات بیشتری میخواهد. | متوسط تا زیاد | STFT و Wavelet Features | زمان-فرکانس |
| استخراج ویژگی خودکار؛ نیازمند داده و اعتبارسنجی قویتر است. | زیادتر | ورودی مستقیم به 1D-CNN | سیگنال خام یکبعدی |
4. دیتاست خوب مهمتر از مدل عجیب است
اگر قرار باشد فقط یک توصیه از این مقاله باقی بماند، این است: پیش از انتخاب معماری شبکه، کیفیت و ساختار دیتاست را بررسی کنید. مرورهای جدید، دیتاستهای مصنوعی، کمبود خرابی واقعی، تغییر شرایط کاری، نویز و عدمتعادل کلاسها را از مهمترین محدودیتهای تشخیص خرابی میدانند [2][3][4].
4.1 CWRU؛ عالی برای شروع، نه اثبات نهایی صنعت
دیتاست Case Western Reserve University یکی از شناختهشدهترین معیارهای آزمایشگاهی تشخیص خرابی بیرینگ است. آزمایشها با موتور ۲ اسب انجام شده، ارتعاش نزدیک بیرینگ ثبت شده و خرابیهای تکنقطهای با روش EDM روی Inner Race، Ball و Outer Race ایجاد شدهاند. دادهها با نرخهای ۱۲ و ۴۸ کیلوهرتز و در بارهای مختلف در دسترس هستند [7]. این دیتاست برای شروع و مقایسه مدلها بسیار مفید است؛ اما خرابی مصنوعی و بستر آزمایش کنترلشده، معادل یک کارخانه واقعی نیست.
4.2 Paderborn؛ قدمی به سمت تنوع واقعیتر
دانشگاه Paderborn علاوه بر ارتعاش، جریان موتور و متغیرهایی مانند سرعت، گشتاور، بار شعاعی و دما را ثبت کرده است. این مجموعه شامل بیرینگ سالم، خرابی مصنوعی و خرابی واقعی حاصل از آزمون عمر شتابدادهشده است [8]. این تنوع برای بررسی همجوشی حسگرها و تعمیم مدل ارزشمند است.
| محدودیت برای ادعای صنعتی | نقاط قوت | دیتاست |
|---|---|---|
| خرابیهای کاشتهشده، بستر آزمایش کنترلشده و خطر Overfitting به Setup | رایج، مستند، چند نوع خرابی و نرخ نمونهبرداری مشخص | CWRU |
| هنوز محیط پژوهشی است و با ماشین هدف شما یکسان نیست. | چند سنسور، چند شرایط کاری، خرابی واقعی و مصنوعی | Paderborn |
| جمعآوری خرابی واقعی زمانبر، پرهزینه و گاهی خطرناک است. | بیشترین شباهت به Deployment واقعی | داده خود دستگاه |
5. تله دقت ۹۹ درصدی: نشت داده
این بخش برای من مهمترین قسمت علمی مقاله است. در تشخیص خرابی، یک اشتباه ساده در جداسازی داده میتواند مدل را تقریباً بینقص نشان دهد. فرض کنید یک فایل ارتعاش طولانی را به پنجرههای ۱۰۲۴ نمونهای با ۷۵ درصد همپوشانی تقسیم کردهایم. اگر بعد از ساخت پنجرهها جداسازی تصادفی انجام شود، پنجرههای بسیار مشابه از همان بیرینگ و همان اجرای آزمون (Run) ممکن است هم در آموزش و هم در آزمون قرار بگیرند. در این حالت، مدل ممکن است بهجای یادگیری الگوی خرابی، امضای همان رکورد را حفظ کند.
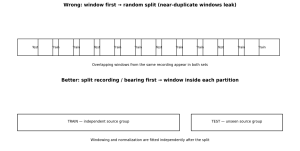
شکل 3 ـ نمایش مفهومی نشت داده در پنجرهبندی (Windowing)
راه امنتر این است که ابتدا Recording یا Bearing را جدا کنیم و سپس داخل هر بخش پنجره بسازیم.
مقاله IEEE Access در سال ۲۰۲۴ با عنوان «Impact of Data Leakage in Vibration Signals Used for Bearing Fault Diagnosis» همین مسئله را بهطور مستقیم بررسی کرده است [6].مقاله Mechanical Systems and Signal Processing در سال ۲۰۲۶ نیز نشان میدهد این خطا همچنان رایج است و پیشنهاد میکند جداسازی داده در سطح بیرینگ انجام شود؛ یعنی داده یک بیرینگ فیزیکی همزمان در مجموعه آموزش و آزمون نباشد [5].نویسندگان همان مقاله گزارش میکنند که تحت پروتکل سختگیرانهتر، در برخی دیتاستها مدلهای کلاسیک مبتنی بر ویژگی حتی میتوانند از Deep Learning بهتر عمل کنند [5].
دقت بالا بدون جداسازی امن از نظر نشت داده برای من مدرک کافی نیست.سؤال درست این است: مدل روی یک بیرینگ، Run، Load یا حتی ماشین جدیدی که در آموزش ندیده، چه عملکردی دارد؟
پروتکل پیشنهادی برای جداسازی داده
• منبع فیزیکی داده را مشخص کنید: Bearing ID، Machine ID، Run ID یا Session ID.
• مجموعههای Train، Validation و Test را در سطح همین گروهها جدا کنید؛ نه در سطح پنجرههای تولیدشده.
• پس از جداسازی، Windowing را بهصورت مستقل داخل هر بخش انجام دهید.
• نرمالسازی، PCA، انتخاب ویژگی و هر Transformer فقط روی Train برازش داده شود و سپس روی Validation و Test اعمال شود.
• اگر هدف، تعمیم بین Load یا Speed است، ارزیابی جداگانه Cross-condition یا Group-based تعریف کنید.
• نتیجه را با Cross-validation مناسب یا بازه اطمینان گزارش کنید؛ نه فقط یک عدد Accuracy .
6.برای STM32 چه مدلی انتخاب کنیم؟همیشه Deep Learning جواب نیست
مدل باید بر اساس نوع مسئله و کیفیت داده انتخاب شود. اگر داده خرابی کم است، تشخیص ناهنجاری یککلاسه گاهی از یک طبقه بندی چندکلاسه منطقیتر است. اگر ویژگیهای فیزیکی مناسبی داریم، SVM، Logistic Regression، Random Forest یا مدلهای درختی میتوانند کوچک، سریع و تفسیرپذیر باشند. اگر الگو پیچیده و داده کافی است، یک 1D-CNN کوچک میتواند استخراج ویژگی را خودکار کند.
| تناسب با MCU | ریسک / هزینه | مزیت | نیاز به برچسب خرابی | مدل / رویکرد |
|---|---|---|---|---|
| بسیار مناسب | نوع خرابی را لزوماً مشخص نمیکند. | شروع سریع با داده سالم | کم؛ عمدتاً داده نرمال | One-class anomaly |
| مناسب | به مهندسی ویژگی (Feature Engineering) وابسته است. | سبک و تفسیرپذیر | بله | Logistic / SVM |
| مناسب تا متوسط | با افزایش تعداد درختها، حافظه رشد میکند. | قوی روی ویژگیهای مهندسی | بله | Random Forest / Tree |
| مناسب با Optimization | RAM / Flash بیشتر و اعتبارسنجی سختتر | یادگیری ویژگی از سیگنال | بله؛ نسبتاً زیاد | 1D-CNN کوچک |
| مناسب با طراحی دقیق | به Threshold و Drift حساس است. | تشخیص ناهنجاری بدون نیاز به برچسب خرابی | اغلب فقط داده نرمال | Autoencoder کوچک |
پژوهش MCUNet نشان داده است که طراحی همزمان مدل و Runtime میتواند مرز اجرای Deep Learning روی MCU را جابهجا کند [17]. از طرف دیگر، CMSIS-NN و TensorFlow Lite Micro نشان میدهند Kernel و Runtime بهاندازه معماری مدل اهمیت دارند [14][15]. بنابراین جمله «مدل روی لپتاپ ۹۸ درصد دقت گرفت» فقط بخشی از داستان است.
7. زنجیره ابزار واقعی STM32؛ از مدل تا کد C
7.1 NanoEdge AI Studio؛وقتی داده خرابی کم است
ST در NanoEdge AI Studio ابزارهایی برای تشخیص ناهنجاری، طبقهبندی و رگرسیون روی STM32 فراهم کرده است [12]. در سناریوهایی که بیشتر عمر تجهیز در حالت سالم میگذرد و جمعآوری همه کلاسهای خرابی دشوار است، یادگیری رفتار نرمال و تشخیص انحراف از آن میتواند انتخاب مناسبی باشد.
7.2 STM32Cube AI Studio؛ برای شبکههای از قبل آموزشدیده
در سال ۲۰۲۶، STM32Cube AI Studio بهعنوان مسیر جدید ST برای آمادهسازی، کوانتیزهسازی، اعتبارسنجی و تبدیل شبکههای عصبی به کد بهینهشده برای STM32 معرفی شد [13]. برای مدلهایی که با TensorFlow/Keras یا PyTorch آموزش داده میشوند، این مسیر کمک میکند پیش از استقرار، حافظه موردنیاز و زمان اجرای مدل بهتر سنجیده شود.
7.3 نمونه رسمی ST برای تشخیص خرابی موتور
در مطالعه موردی رسمی ST برای تشخیص خرابی موتور، از برد STEVAL-PROTEUS1، سنسور ISM330DHCX و NanoEdge AI Studio استفاده شده است و حالتهایی مانند عدمتعادل، خرابی بیرینگ و ناهمراستایی (Misalignment) بررسی شدهاند [11]. نکته مهم این مثال فقط مدل نیست؛ ثبت داده، سنسور، پیشپردازش، کتابخانه، Firmware و مسیر ارسال نتیجه همگی بخشی از سیستم هستند. ST همچنین یک Function Pack برای نگهداری پیشگویانه روی همین خانواده ارائه کرده است [18].
8. معماریای که برای یک پروتوتایپ صنعتی پیشنهاد میدهم
اگر بخواهم یک نمونه اولیه قابل دفاع بسازم، بخش دریافت داده (Acquisition) را از استنتاج مدل (Inference) جدا میکنم و خروجی مدل را مستقیماً به فرمان حساس وصل نمیکنم. بین مدل و عملگر یک لایه تصمیم قرار میدهم تا Confidence، Hysteresis، چند پنجره متوالی و قواعد مهندسی را بررسی کند.
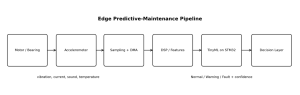 شکل 4 ـ مسیر پیشنهادی از سنسور تا لایه تصمیم.
خروجی مدل بهتر است پیش از Alarm یا Action از منطق اطمینان و پایداری عبور کند.
| نکته اجرایی | وظیفه | لایه |
|---|---|---|
| DMA، Timestamp، کنترل ODR و جلوگیری از Drop | خواندن شتابسنج یا ADC | Acquisition |
| پارامترها باید دقیقاً با Training یکسان باشند. | حذف DC، فیلتر و پنجرهبندی | Preprocessing |
| بودجه CPU و RAM از ابتدا اندازهگیری شود. | RMS، FFT، Band Energy یا Raw Window | Feature / DSP |
| در صورت نیاز از INT8 و Kernel بهینه استفاده شود. | Anomaly / Classifier / Regression | Inference |
| از Alarm لحظهای و ناپایدار جلوگیری میکند. | Confidence، Hysteresis و Voting | Decision Layer |
| خلاصه ارسال شود؛ Raw Data فقط برای رخدادهای مهم ذخیره شود. | Event، Health Score و Metadata | Telemetry |
9. حلقه Firmware باید Real-Time باشد، نه یک Demo مسدودکننده
در یک نسخه نمایشی میتوان چند ثانیه Sampling انجام داد، سپس FFT گرفت، مدل را اجرا کرد و نتیجه را چاپ کرد. در محصول واقعی، Sampling نباید هنگام Inference متوقف شود. استفاده از Double Buffer، DMA یا جداسازی Taskها میتواند دریافت داده را از پردازش جدا کند.
while (system_running) {
if (new_window_ready) {
preprocess(buffer_ready);
features = extract_features(buffer_ready);
score = run_model(features);
state = decision_logic(score, history, thresholds);
log_event(state, score, operating_point);
}
}
در این معماری باید بدترین زمان اجرای هر مرحله، سرریز بافر، Watchdog، Peak RAM و رفتار سیستم هنگام قطع سنسور یا خرابشدن داده آزمایش شود. TinyML زمانی به محصول صنعتی نزدیک میشود که Failure Mode نرمافزار نیز بهاندازه خود مدل جدی گرفته شود.
10. Accuracy تنها معیار نیست؛ برای کارخانه چه چیزی را گزارش کنیم؟
MLPerf Tiny از ابتدا دقت را در کنار زمان اجرا و انرژی قرار داده است [16]. در یک پروژه نگهداری پیشگویانه صنعتی، من مجموعه معیارها را کاملتر میبینم:
| سؤال مهندسی | چرا مهم است؟ | معیار |
|---|---|---|
| از ۱۰۰ خرابی واقعی، چند مورد را تشخیص میدهیم؟ | از دستدادن خرابی میتواند پرهزینه باشد. | Recall / Sensitivity |
| از Alarmها چند درصد واقعاً مربوط به خرابی هستند؟ | False Alarm زیاد اعتماد اپراتور را کم میکند. | Precision |
| در Thresholdهای مختلف چه رفتاری داریم؟ | در داده نامتوازن از Accuracy تنها اطلاعات بیشتری میدهند. | F1 / AUROC / PR-AUC |
| هر پنجره چند میلیثانیه زمان میبرد؟ | تصمیم باید پیش از Deadline آماده باشد. | Latency |
| مدل، DSP و Stack همزمان در حافظه جا میشوند؟ | محدودیت واقعی MCU است. | Peak RAM / Flash |
| Energy per Inference یا Duty Cycle چقدر است؟ | برای گره باتریخور و Always-on مهم است. | Energy / Power |
| Noise، Load، Speed و Sensor Position چه اثری دارند؟ | شرایط کارخانه تغییر میکند. | Robustness |
| وقتی مدل مطمئن نیست، سیستم چه تصمیمی میگیرد؟ | Probability خام همیشه قابل اعتماد نیست. | Calibration / Confidence |
در سیستم واقعی، هزینه False Negative و False Positive یکسان نیست. Threshold باید بر اساس ریسک و هزینه تعمیر یا توقف تنظیم شود؛ نه فقط بر اساس نقطهای که Accuracy روی Test Set بیشترین مقدار را دارد.
11. آیا واقعاً میتوان پیش از خرابی هشدار داد؟
بله؛ به شرطی که علائم قابل اندازهگیری پیش از خرابی نهایی ظاهر شوند و سیستم بتواند آن تغییر را بهصورت پایدار تشخیص دهد. با این حال، «هشدار زودهنگام» با «تخمین زمان باقیمانده تا خرابی» تفاوت بزرگی دارد. اولی میتواند با Anomaly Score و Trend انجام شود؛ دومی معمولاً به داده Run-to-Failure، تعریف Failure Threshold و یک مدل Prognostics نیاز دارد.
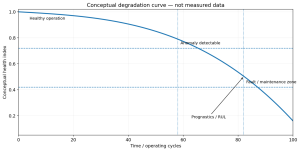
شکل ۵ ـ نمودار مفهومی تخریب.این شکل داده آزمایشگاهی نیست و فقط برای جداکردن Detection/Diagnosis از Prognostics و RUL رسم شده است.
اگر فقط Snapshotهای سالم و خراب داشته باشیم، میتوانیم Detection یا Classification بسازیم؛ اما نمیتوانیم با صداقت علمی ادعا کنیم «۷۲ ساعت تا خرابی باقی مانده است». برای چنین ادعایی باید مسیر تخریب در طول زمان مشاهده شده باشد. همین تفاوت، مرز یک ادعای تبلیغاتی با کار مهندسی جدی است.
12. یک پروتکل آزمایش که نتیجهاش قابل دفاع باشد
• 1. Failure Mode را دقیق تعریف کنید؛ مثلاً Outer-race defect یا Misalignment، نه عنوان کلی «خرابی موتور».
• 2. محدوده عملیاتی (Operating Envelope) را مشخص کنید: RPM، Load، Temperature، Mounting و Sensor Position.
• 3. از چند ماشین یا بیرینگ سالم، Baseline کافی جمع کنید؛ نه فقط از یک نمونه.
• 4. داده را در سطح Bearing یا Run جدا کنید و سپس Windowing انجام دهید تا خطر نشت داده کاهش یابد [5][6].
• 5. یک Baseline ساده بسازید؛ برای مثال RMS/FFT همراه با Logistic، SVM یا Tree. استفاده از شبکه عمیق باید دلیل فنی داشته باشد، نه فقط جذابیت ظاهری.
• 6. مدل را روی شرایط ندیده، بیرینگ جدید و سطح نویز متفاوت آزمایش کنید.
• 7. مدل را روی MCU هدف Profile کنید و Latency، Flash، Peak RAM و Energy را اندازه بگیرید.
• 8. Threshold را بر اساس Cost of Error تنظیم کنید و منطق Alarm را با Hysteresis یا Voting پایدار کنید.
• 9. Drift Monitoring تعریف کنید؛ اگر رفتار ماشین یا سنسور تغییر کرد، سیستم باید این تغییر را قابل مشاهده کند.
• 10. Field Data را برای بازآموزی و تحلیل ریشهای خطا ذخیره کنید.
13. اگر بخواهم از فردا پروتوتایپ را شروع کنم، این نقشه راه را میروم
| معیار عبور | خروجی قابل تحویل | فاز |
|---|---|---|
| عدم Drop / Leakage و تکرارپذیری اندازهگیری | Logger پایدار، دیتاست نسخهبندیشده و گزارش ویژگیها | A — Data & DSP |
| Recall / Precision قابل قبول روی منابع ندیده | مدل ساده با اعتبارسنجی Leakage-safe | B — Baseline ML |
| Latency / RAM / Flash داخل بودجه طراحی | Firmware روی STM32 همراه با Profiling | C — TinyML Deployment |
| افت عملکرد کنترلشده و قابل توضیح | تست Load / Speed / Noise / Sensor Shift | D — Robustness |
| False Alarm قابل تحمل و امکان Trace-back | Health Score، Alert و Logging | E — Field Trial |
14. چند اشتباه که از همان ابتدا حذف میکنم
• Random Split روی Windowهای یک Recording و سپس گزارش Accuracy نزدیک ۱۰۰ درصد.
• استفاده از یک Bearing برای Train و همان Bearing برای Test و سپس ادعای Generalization.
• استفاده از Test Set برای انتخاب Feature، Threshold یا Hyperparameter.
• انتخاب CNN فقط به این دلیل که «AIتر» به نظر میرسد، بدون مقایسه با یک Baseline ساده.
• گزارش Accuracy بدون Confusion Matrix، Recall کلاس خرابی و توضیح شرایط کاری.
• گزارش اندازه مدل بدون Peak RAM و Latency واقعی روی MCU هدف.
• استفاده از عنوان Predictive Maintenance برای یک Classifier سالم/خراب، بدون داشتن داده زمانی تخریب.
• وصلکردن مستقیم Probability مدل به Alarm یا Actuator بدون Decision Logic و Hysteresis.
15. چکلیست نهایی: آیا مدل TinyML من آماده نزدیکشدن به صنعت است؟
☐ سنسور و محل نصب بر اساس باند فرکانسی هدف انتخاب شده است.
☐ Sampling و Anti-aliasing مشخص و مستند هستند.
☐ Train و Test در سطح Bearing، Run یا Machine از هم جدا شدهاند.
☐ Windowing بعد از Split انجام شده و نشت داده بررسی شده است.
☐ یک Baseline کلاسیک با مدل پیچیده مقایسه شده است.
☐ Recall، Precision و False Alarm Rate در کنار Accuracy گزارش شدهاند.
☐ مدل روی Load، Speed و Noise ندیده آزمایش شده است.
☐ Latency، Peak RAM، Flash و Energy روی MCU هدف اندازهگیری شدهاند.
☐ Threshold و منطق Confidence تعریف شدهاند.
☐ Alarm با Hysteresis یا Voting پایدار شده است.
☐ رفتار سیستم در Sensor Failure و Buffer Overrun مشخص است.
☐ Raw Event Data برای Debug و Re-training قابل ذخیره است.
☐ تفاوت Detection، Diagnosis و RUL در ادعاهای پروژه رعایت شده است.
جمعبندی؛STM32 میتواند هوشمند باشد، اما علم از مدل شروع نمیشود.
استفاده از TinyML روی STM32 برای پایش وضعیت موتور یک مسیر عملی است؛ ابزارهای رسمی، Runtime های بهینه و نمونههای واقعی برای آن وجود دارند [11][12][13][18]. اما چیزی که یک Demo را از یک سیستم مهندسی جدا میکند، معمولاً تعداد لایههای شبکه نیست.
برای من مسیر درست این است: مسئله را دقیق تعریف کنیم، داده را درست جمعآوری کنیم، نشت داده را حذف کنیم، با یک Baseline ساده شروع کنیم، مدل را روی شرایط ندیده بسنجیم و فقط بعد از آن سراغ بهینهسازی روی MCU برویم. اگر این زنجیره درست باشد، STM32 میتواند همان کنار موتور، ارتعاش خام را به یک Health Score یا Alarm قابل اتکا تبدیل کند.
جمله آخردر نگهداری پیشگویانه واقعی، «هوشمندی» فقط داخل شبکه عصبی نیست؛ در سنسور، طراحی آزمایش، جداسازی داده، ویژگیها، Runtime، Firmware و منطق تصمیمگیری پخش شده است.
منابع و مراجع
[1] E. Njor, M. A. Hasanpour, J. Madsen, and X. Fafoutis, “A Holistic Review of the TinyML Stack for Predictive Maintenance,” IEEE Access, vol. 12, pp. 184861–184882, 2024. DOI: 10.1109/ACCESS.2024.3512860. [Link]
[2] R. Puntambekar, P. Vyas, A. Thakkar, and D. Patel, “A survey of machine learning and deep learning methods for vibration-based bearing fault diagnosis,” Neurocomputing, vol. 659, 131628, 2026. DOI: 10.1016/j.neucom.2025.131628. [Link]
[3] O. Matania, I. Dattner, J. Bortman, R. S. Kenett, and Y. Parmet, “A systematic literature review of deep learning for vibration-based fault diagnosis of critical rotating machinery,” Journal of Sound and Vibration, vol. 590, 118562, 2024. DOI: 10.1016/j.jsv.2024.118562. [Link]
[4] A. A. Soomro et al., “Insights into modern machine learning approaches for bearing fault classification: A systematic literature review,” Results in Engineering, vol. 23, 102700, 2024. DOI: 10.1016/j.rineng.2024.102700. [Link]
[5] J. P. Vieira, V. A. Bauler, R. Kobashikawa Rosa, and D. Silva, “Towards a more realistic evaluation of machine learning models for bearing fault diagnosis,” Mechanical Systems and Signal Processing, vol. 258, 114640, 2026. DOI: 10.1016/j.ymssp.2026.114640. [Link]
[6] L. Wheat, M. V. Mohrenschildt, S. Habibi, and D. Al-Ani, “Impact of Data Leakage in Vibration Signals Used for Bearing Fault Diagnosis,” IEEE Access, vol. 12, pp. 169879–169895, 2024. DOI: 10.1109/ACCESS.2024.3497716. [Link]
[7] Case Western Reserve University, Bearing Data Center — bearing fault data, apparatus and data files. [Link]
[8] Paderborn University, KAt Bearing Data Center — vibration/current measurements and bearing datasets. [Link]
[9] S. Arciniegas, D. Rivero, J. Piñan, E. Diaz, et al., “IoT device for detecting abnormal vibrations in motors using TinyML,” Discover Internet of Things, vol. 5, article 41, 2025. DOI: 10.1007/s43926-025-00142-4. [Link]
[10] A. F. Cotrino Herrera, J. A. López Sotelo, J. C. Blandón Andrade, and A. Toro Lazo, “Low-cost prototype for bearing failure detection using Tiny ML through vibration analysis,” HardwareX, vol. 22, e00658, 2025. DOI: 10.1016/j.ohx.2025.e00658. [Link]
[11] STMicroelectronics, “How to implement motor fault detection and classification for predictive maintenance,” ST Edge AI Suite case study. [Link]
[12] STMicroelectronics, NanoEdge AI Studio — automated ML tool for anomaly detection, classification and regression on STM32. [Link]
[13] STMicroelectronics, “STM32Cube AI Studio: new UI, more intuitive UX, additional power user features,” 2026. [Link]
[14] L. Lai, N. Suda, and V. Chandra, “CMSIS-NN: Efficient Neural Network Kernels for Arm Cortex-M CPUs,” 2018. [Link]
[15] R. David et al., “TensorFlow Lite Micro: Embedded Machine Learning on TinyML Systems,” 2020. [Link]
[16] C. Banbury et al., “MLPerf Tiny Benchmark,” NeurIPS Datasets and Benchmarks, 2021. [Link]
[17] J. Lin, W.-M. Chen, Y. Lin, J. Cohn, C. Gan, and S. Han, “MCUNet: Tiny Deep Learning on IoT Devices,” NeurIPS 2020. [Link]
[18] STMicroelectronics, FP-AI-PDMWBSOC2 — STM32Cube function pack for AI anomaly detection and classification for predictive maintenance. [Link]
[19] MLCommons, “MLPerf Tiny: Benchmarking AI at the Edge,” v1.4 overview, July 2026. [Link]
درباره نویسندهمینا حسنزاده، مهندس برق و الکترونیک، فعال در حوزه سیستمهای نهفته، STM32 و ESP32، طراحی سختافزار و PCB، اینترنت اشیا و توسعه محصول. تمرکز این مجموعه مقاله بر فاصله میان «پروتوتایپ آزمایشگاهی» و «سیستم قابل اتکا در محیط واقعی» است.

 نویسنده: مینا حسن زاده
متخصص الکترونیک
مهندس برق و الکترونیک با تمرکز بر Embedded Systems و IoT است. تجربه کاری او شامل طراحی و تست سختافزار، توسعه Firmware برای STM32 و ESP32، طراحی پروتکل ارتباطی، PCB، پروژههای خودرویی، تجهیزات پزشکی و یکپارچهسازی سختافزار با اپلیکیشن Flutter است.
مقالات بیشتر
پالت | بازار خرید و فروش قطعات الکترونیک
قطعات اضافه و بدون استفاده همیشه یکی از سربارههای شرکتها و طراحان حوزه برق و الکترونیک بوده و هست. پالت سامانهای است که بصورت تخصصی اجازه خرید و فروش قطعات مازاد الکترونیک را فراهم میکند. فروش در پالت
آیسی | موتور جستجوی قطعات الکترونیک
سامانه آی سی سیسوگ (Isee) قابلیتی جدید و کاربردی از سیسوگ است. در این سامانه سعی شده است که جستجو، انتخاب و خرید مناسب تر قطعات برای کاربران تسهیل شود. جستجو در آیسی
سیسوگشاپ | فروشگاه محصولات Quectel
فروشگاه سیسوگ مجموعه ای متمرکز بر تکنولوژی های مبتنی بر IOT و ماژول های M2M نظیر GSM، GPS، LTE، NB-IOT، WiFi، BT و ... جایی که با تعامل فنی و سازنده، بهترین راهکارها انتخاب می شوند. برو به فروشگاه سیسوگ
سیسوگ فروم | محلی برای پاسخ پرسشهای شما
دغدغه همیشگی فعالان تخصصی هر حوزه وجود بستری برای گفتگو و پرسش و پاسخ است. سیسوگ فروم یک انجمن آنلاین است که بصورت تخصصی امکان بحث، گفتگو و پرسش و پاسخ در حوزه الکترونیک را فراهم میکند. پرسش در سیسوگ فرم
سیکار | اولین مرجع متن باز ECU در ایران
بررسی و ارائه اطلاعات مربوط به ECU (واحد کنترل الکترونیکی) و نرمافزارهای متن باز مرتبط با آن برو به سیکار
سیسوگ با افتخار فضایی برای اشتراک گذاری دانش شماست. برای ما مقاله بنویسید.